MtGaze 公開版を出した — MTGデッキ構築・カード検索ツール
以前、自作WEBサービス紹介シリーズで MtGaze を取り上げた。あのときは「身内4人専用、一般公開はしない」と書いた。その方針を変え、機能を絞った公開版を一般公開したので、その続報を書く。
公開版は登録不要・無料で、ブラウザだけで完結する。物理カードの認識やリモート対戦といった身内向けの機能は含まず、カードデータベースとして使える部分を切り出した形になる。
1. 概要
公開版 MtGaze は、Magic: The Gathering のためのカード検索・デッキ構築・パック開封ツールである。次の3つを柱としている。
- カード検索 — 日本語・英語どちらの名前でもカードを引ける
- デッキ構築+診断 — デッキを作り、事故率やマナベースを診断できる
- パックシミュレータ — セットを選んでパック開封を体験できる
いずれも登録・ログインなしで使える。デッキデータはサーバではなくブラウザ内に保存されるため、アカウントを作る必要がない。
公開URLは以下。
https://mtgaze.eisenhower-daimo.com/
2. 公開版で使える機能
カード検索
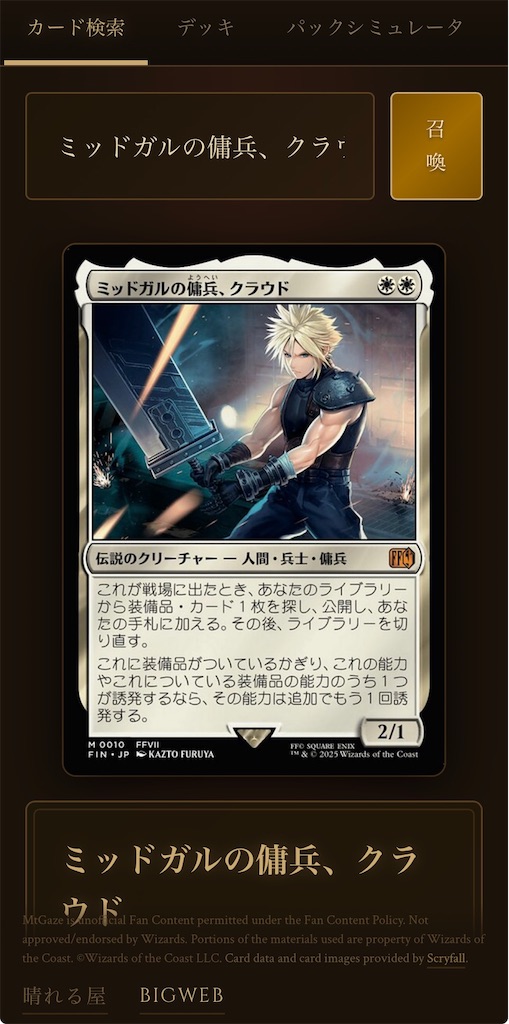
カード名から詳細情報を検索する。日本語名・英語名のどちらにも対応している。海外のカードデータベースは日本語名での検索が弱いことが多いが、本ツールは「稲妻」のような日本語名でそのまま引ける。
- 日本語・英語名で検索
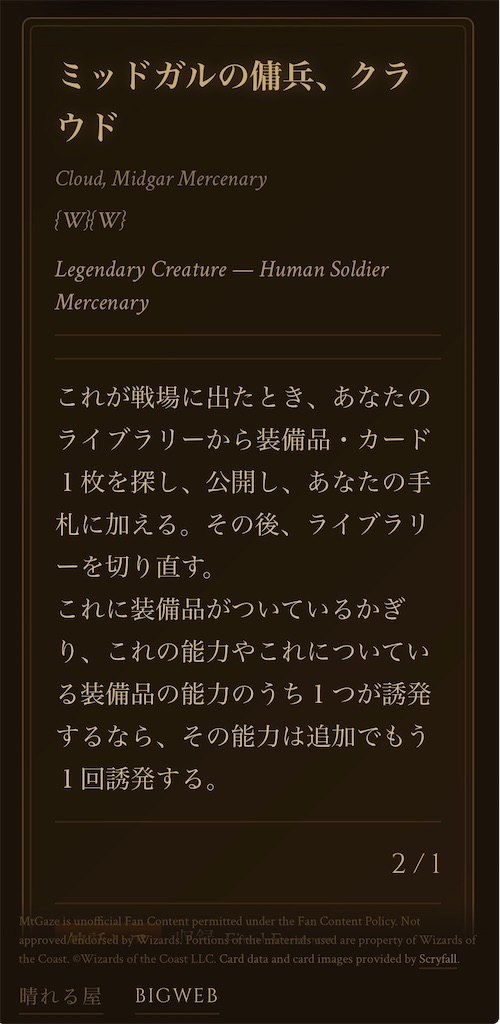
- カード画像・カードテキストの表示
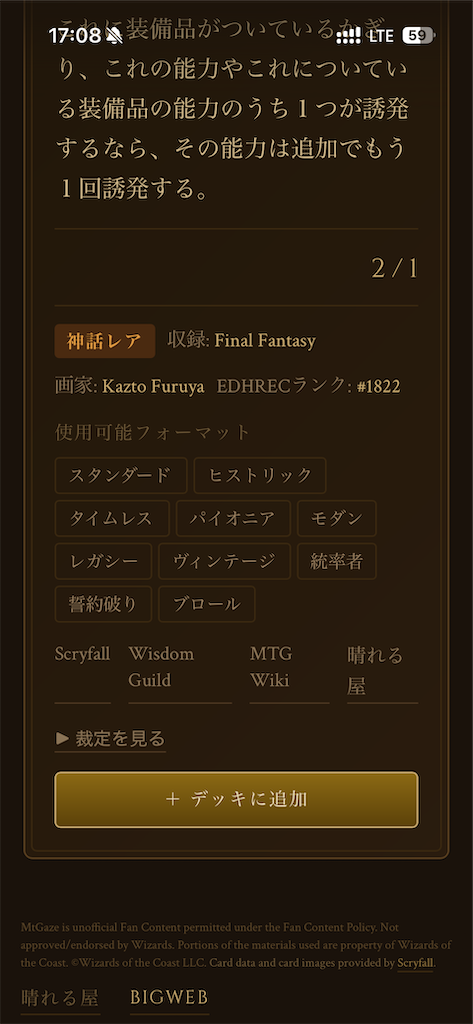
- 裁定(公式ルーリング)をパネル内にインライン表示
- Scryfall / Wisdom Guild / MTG Wiki へのリンク
- 検索結果からそのままデッキへ追加
デッキ構築+診断
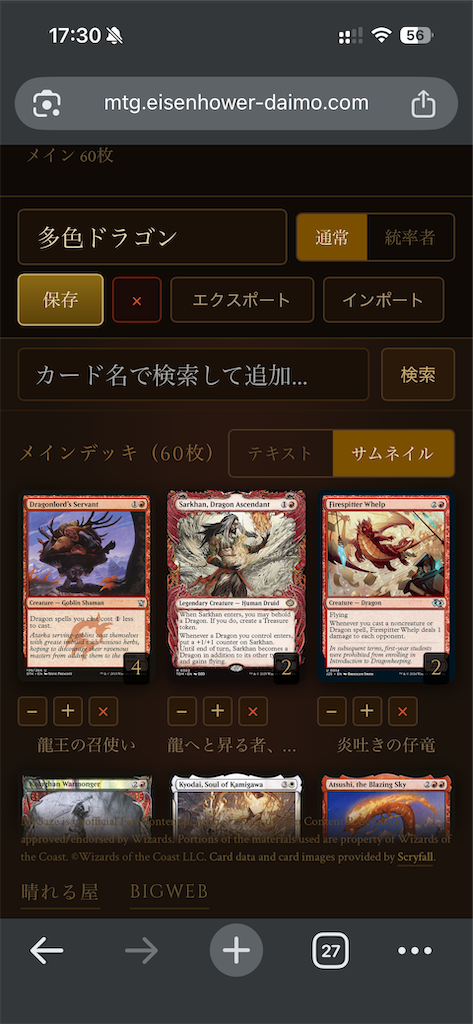
通常デッキと統率者(EDH)デッキの作成・管理ができる。MTG Arena・晴れる屋形式のテキストからインポート/エクスポートできるので、手持ちのデッキリストをそのまま流し込める。
- デッキ作成・削除(通常/統率者)
- テキスト形式でのインポート/エクスポート
- サムネイル一覧・ドラッグ&ドロップ並び替え
- マナカーブ・カード種別の統計
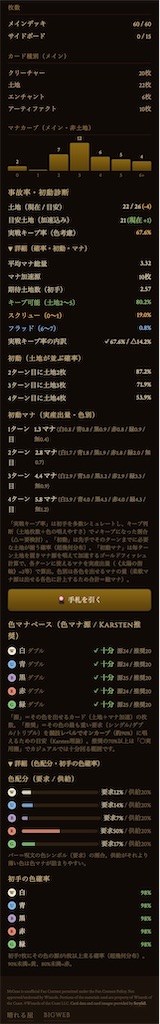
デッキ構築の主役は診断機能である。組んだデッキが「実際に回したときどれくらい安定するか」を、確率に基づいて可視化する。
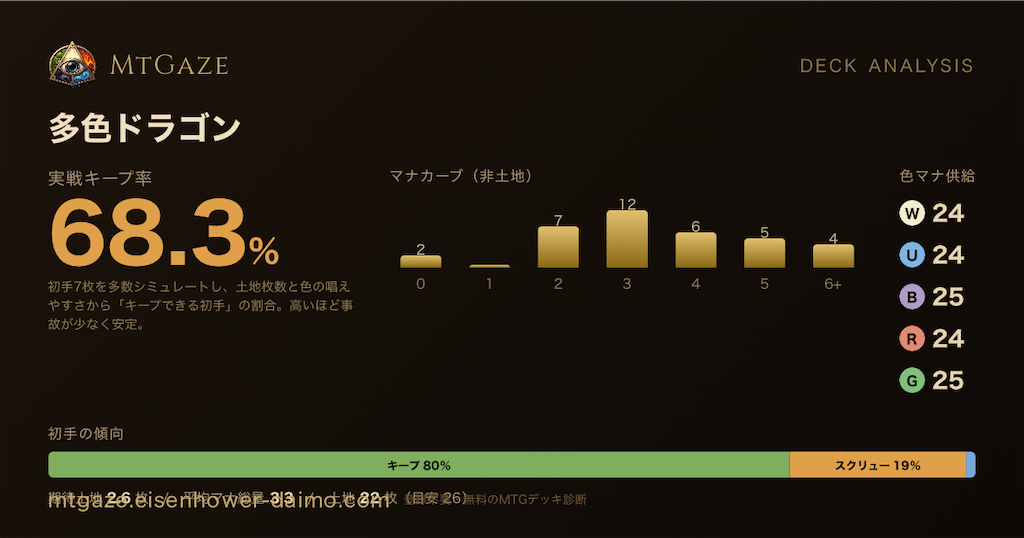
- 事故率・初動診断 — 初手の土地分布、実戦キープ率、初動マナを算出する
- 色マナベース診断 — 各色の供給源を数え、推奨ソース数と比較する
- 手札シミュレータ — 初手7枚を扇形で引き、キープ/マリガンの判断を練習できる。何度でも引き直せる
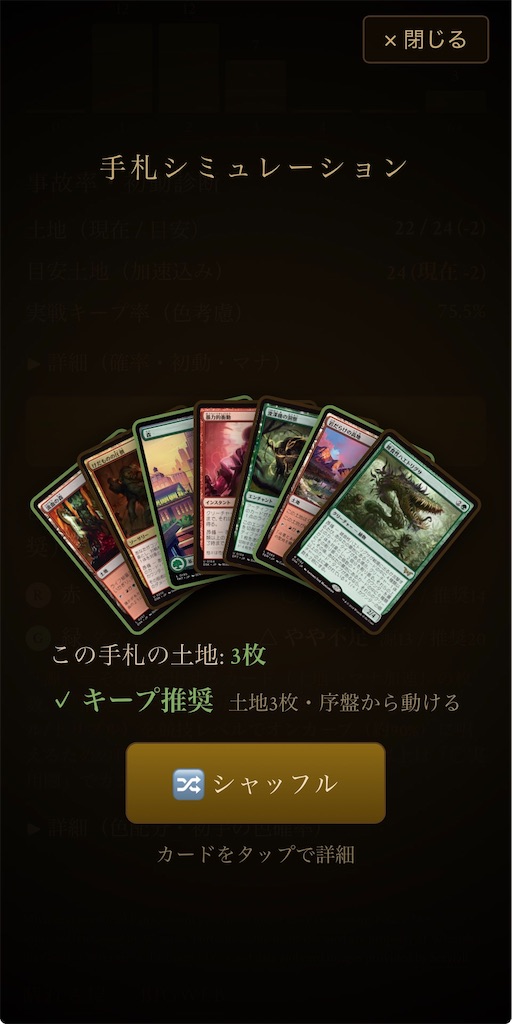
事故率や初手の色確率は超幾何分布(くじ引きの確率モデル)で算出し、色マナベースの推奨ソース数は Frank Karsten のマナベース理論を基準にしている。実戦キープ率は初手のモンテカルロ・シミュレーションで求めている。理論的な詳細はアプリ内の解説と、後述のZenn記事に譲る。
パックシミュレータ
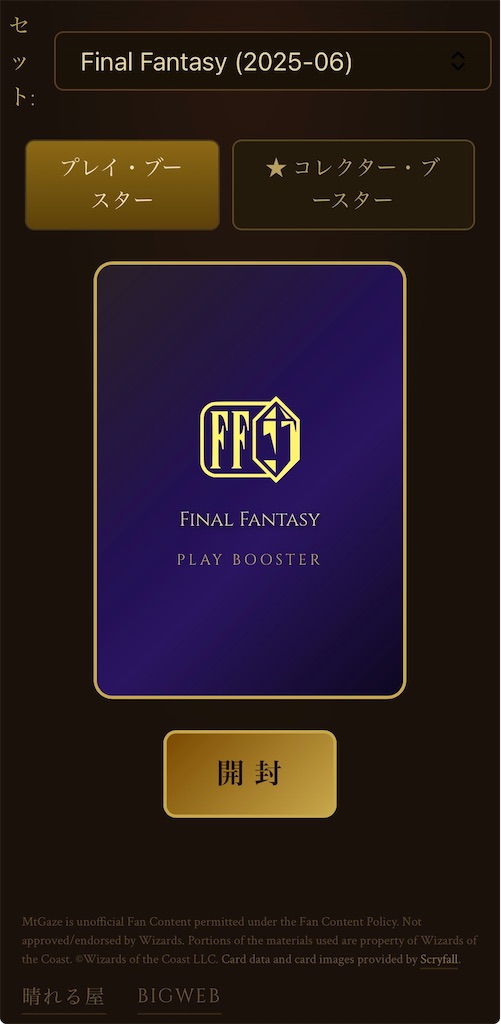
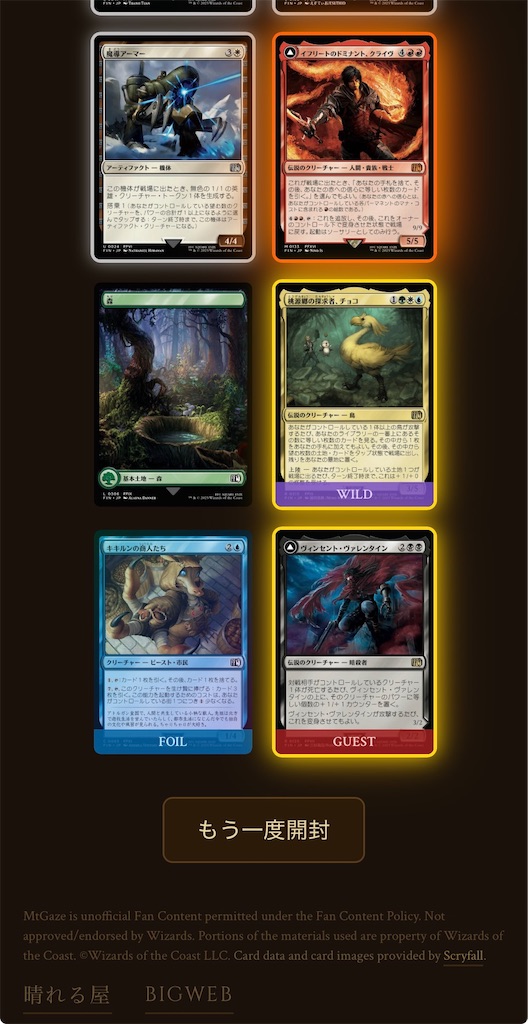
セットを選び、ブースターパックの開封を体験できる。プレイ・ブースターとコレクター・ブースターの両方に対応している。
- セット選択・パック開封アニメーション
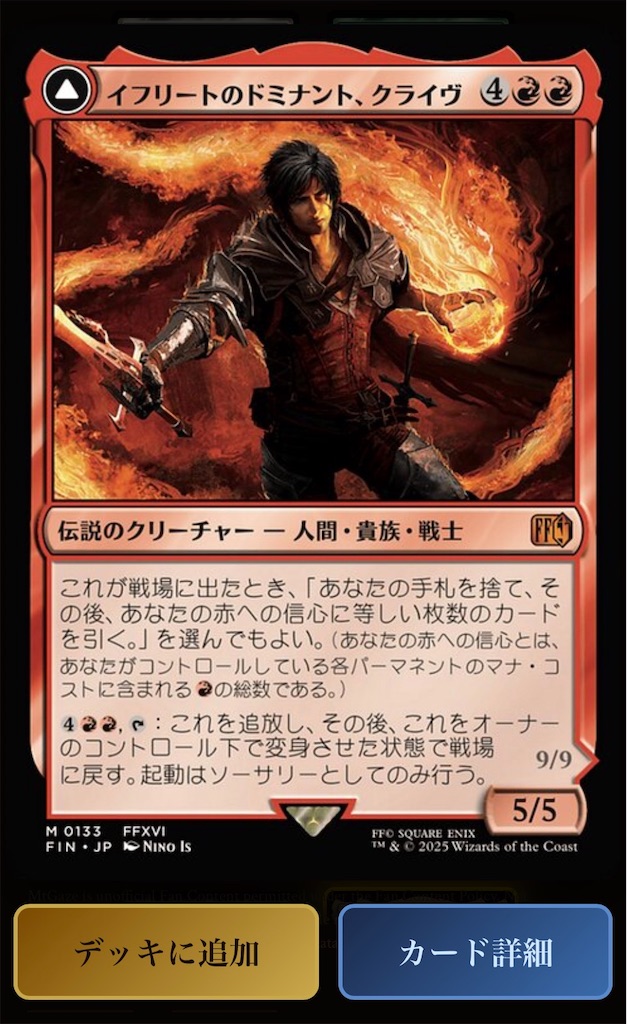
- レアリティ演出、フォイル/ホロ表現
- 剥いたカードはタップで詳細表示・そのままデッキへ追加
実用というより遊びの機能だが、新セットの中身を眺めたり、開封の運試しをするのに向いている。
共有機能
デッキ診断の結果を画像として書き出し、SNSに貼れる。キープ率やマナカーブを1枚の画像にまとめるので、「このデッキのキープ率は何%だった」を手軽に共有できる。画像はブラウザ内で生成され、デッキデータがサーバに送られることはない。
3. 今後・関連記事
公開版はサービス紹介を目的とした本記事の範囲に留め、実装面の話は別途 Zenn に書く予定である。1つのコードベースから身内版と公開版を出し分ける仕組みや、Fan Content Policy・Scryfall のガイドラインを設計にどう落とし込んだかといった技術的な内容は、そちらで扱う。
まずは触ってもらうのが早い。気になった機能から試してほしい。
https://mtgaze.eisenhower-daimo.com/
カードデータ・画像は Scryfall を利用している。
MtGaze is unofficial Fan Content permitted under the Fan Content Policy. Not approved/endorsed by Wizards. Portions of the materials used are property of Wizards of the Coast. ©Wizards of the Coast LLC.
2027 Will Be the Year of Harmonic Engineering — Calling It Now
The competitive axis of AI development shifts almost every year. This post is a survey stake, planted to organize my thinking and check back later.
| Year | Concept | What determines outcomes |
|---|---|---|
| 2024 | Prompt Engineering | Quality of instructions to the model |
| 2025 | Agentic Engineering | Quality of delegation to agents |
| 2026 | Harness Engineering | Quality of the environment agents run in |
| 2027 | Harmonic Engineering (my coinage) | Quality of coordination across agents |
What comes after the harness
Harness engineering took off in February 2026, when Mitchell Hashimoto coined the term and OpenAI effectively endorsed it days later. Rule files like CLAUDE.md, pre-execution gates, context management — the discipline of designing an environment where a single agent runs without going off the rails.
Once that groundwork is done, the next bottleneck seems obvious. Agents don’t work alone. A high-capability cloud model paired with a cheap local model. An implementer paired with a reviewer. A main line paired with a shadow run. When multi-agent configurations become the default, the problem shifts from “how do I control each one” to “how do I make them play in concert.”
I’m calling this harmonic engineering.
Open problems in coordination design (as I see them today)
- Escalation: Route to a stronger model only when local and cloud outputs diverge. Always-on dual execution is too expensive
- Shadow execution: Run a cheap model on the same task in parallel and use the diff against the main line as a quality signal
- Fixed role assignment: Assign implementation, review, and verification to different models, structurally eliminating the blind spots of single-model self-review
None of this works unless the harness — single-agent control — is already in place. These layers stack; they don’t replace each other.
Scoring this prediction in 2027
The shift from prompts to harnesses followed a pattern: practitioners worked out the techniques first, and the name arrived afterward. Coordination will follow the same path. The raw material for the next concept is already sitting in the workflows of people burning themselves out on multi-model setups today.
This isn’t a prophecy so much as a survey stake. I’ll come back at the end of 2027 and check the alignment.
Japanese version: 2027年はハーモニックエンジニアリングの年になる、と勝手に予言しておく
Reference
2027年はハーモニックエンジニアリングの年になる、と勝手に予言しておく
AI開発の競争軸は毎年のように移っている。頭の整理を兼ねて、この流れを記録しておく。
| 年 | 概念 | 競争軸 |
|---|---|---|
| 2024 | プロンプトエンジニアリング | モデルへの指示の質 |
| 2025 | エージェンティックエンジニアリング | エージェントへの任せ方の質 |
| 2026 | ハーネスエンジニアリング | エージェントを走らせる環境の質 |
| 2027 | ハーモニックエンジニアリング(仮称・自称) | 複数エージェントの協調の質 |
ハーネスの次に来るもの
ハーネスエンジニアリングは2026年2月、Mitchell Hashimoto氏の命名をOpenAIが追認する形で広まった。CLAUDE.mdのようなルールファイル、ツール実行前のゲート、コンテキスト管理。単一エージェントを暴走させずに走らせる環境設計の話だ。
この整備が一巡すると、次のボトルネックは自明に思える。エージェントは1体では使われない。クラウドの高性能モデルとローカルの安価なモデル、実装担当とレビュー担当、本線とシャドー実行。複数の奏者が並走する構成が標準になったとき、問題は「個々をどう御すか」から「全体をどう合奏させるか」に移る。
これをハーモニックエンジニアリングと呼ぶことにする。
協調設計の論点(現時点の見立て)
- エスカレーション: ローカルとクラウドの出力が乖離したときだけ上位モデルに裁定させる。常時2重実行はコストが許さない
- シャドー実行: 安価なモデルに同じタスクを並走させ、本線との差分を品質シグナルとして使う
- 役割分担の固定化: 実装・レビュー・検証を別モデルに割り当て、単一モデルの自己レビューによる盲点を構造的に潰す
いずれもハーネス(単体の制御)が前提として整っていないと成立しない。積み重ねの関係であって、置き換えではない。
答え合わせは2027年に
プロンプト→ハーネスの移行は、先行して実践していた人たちの手元の工夫に、後から名前が付いた。協調の領域も同じ経路をたどるはずで、いま複数モデル構成で消耗している人の手元に、次の概念の素材がある。
この記事は予言というより測量杭。2027年末に答え合わせをする。
参考
RaspberryPi Camera再燃
2年前にRaspberry Pi 4B + HQカメラモジュールで天体撮影カメラを作った記事を書いた。iPhoneのショートカットからSSH経由でPythonスクリプトを叩き、libcamera-still をsubprocessで起動して撮影する構成だ。オリオン星雲が撮れて満足していたのだが、露光時間の倍以上に処理時間がかかる遅さがずっと気になっていた。
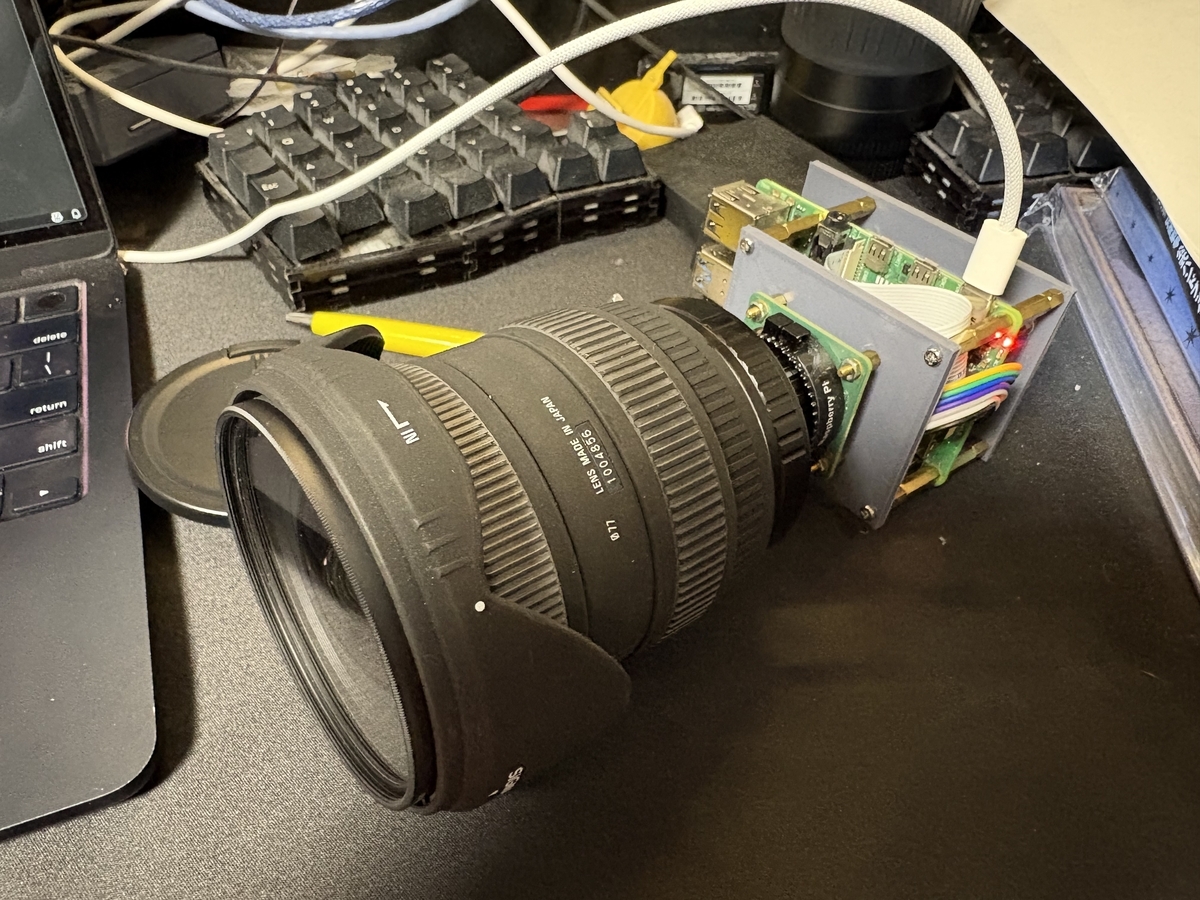 誰がどう言おうと、デジカメである。
しばらく放置していたところ、その後 Picamera2 というライブラリが登場していた。libcamera-still コマンドをsubprocessで毎回起動するのではなく、Pythonから直接カメラを制御するAPIだ。プロセスに常駐させてカメラを起動したままにすれば、起動コストが丸ごと消えるはずだ。
実際に移行してみたら想定通り速くなったのだが、計測するまで気づかなかった問題が2つあった。その話をまとめる。
旧構成と新構成
旧構成: シャッターごとに libcamera-still をsubprocess起動する。コードはシンプルだが、毎回カメラの初期化が走る。
subprocess.run([
    "libcamera-still",
    "--shutter", str(exposure_us),
    "--awbgains", "1.5,1.5",
    "--output", path,
], check=True)
新構成: プロセス起動時に一度だけ初期化し、あとはキャプチャAPIを呼び続ける。
cam = Picamera2()
config = cam.create_still_configuration(
    main={"size": (4056, 3040)},
    lores={"size": (320, 240)},
)
cam.configure(config)
cam.start()

# 以降は cam.capture_file() を繰り返すだけ
ベンチマーク結果
連写スループット(5枚、露光10ms)
| 構成 | 5枚合計 | 1枚あたり |
|---|---|---|
| 旧: libcamera-still | 10.7秒 | 2.08秒 |
| 新: Picamera2常駐 | 3.4秒 | 0.68秒 |
3.1倍。ほぼ期待通りで、起動コストがそのまま差として出た。
シャッターラグ(撮影指示〜ファイル保存完了)
最小0.38秒、平均0.46秒。目標にしていた「0.5秒以内」を安定して達成できた。
プレビューFPS(main 4056×3040 + lores 320×240 並行)
9.5fps。full解像度のmainストリームとloresストリームを同時に流してこの数値が出たので、プレビュー表示としては十分だ。
ここまでは想定通りだった。問題は長時間露光のベンチマークを取り始めてから起きた。
落とし穴①:AWBをオンにすると長時間露光が3.8倍遅くなる
露光2秒で撮影したら1枚目に10秒かかった。最初は計測バグを疑った。
| 構成 | 1枚目の所要時間 |
|---|---|
| Picamera2 AWBオン(デフォルト) | 10.14秒 |
| Picamera2 AWBオフ | 2.65秒 |
| libcamera-still AWBオフ | 4.3秒 |
原因はAWB(オートホワイトバランス)の仕組みにある。AWBは「白が白に見えるか」を判定するために、実際のフレームを数枚撮って輝度・色温度を計測し、収束させる。問題は、その収束フレームも指定した露光時間(2秒)で撮られることだ。露光2秒でAWBが4フレーム収束に使うなら8秒が収束待ちに消える。合計10秒になる計算は合っている。
解決は AwbEnable=False にして、ホワイトバランスの固定値を ColourGains で渡すだけだ。
cam.set_controls({
    "AwbEnable": False,
    "ColourGains": (1.5, 1.5),   # r, b のゲインを固定値で指定
})
天体撮影では色温度が安定しているので固定値で問題ない。
落とし穴②:buffer_count=1(デフォルト)だと連続長時間露光が2倍遅くなる
AWBオフで問題は解決したと思っていた。連続3枚で計測したら2枚目から突然2倍かかるようになった。しかもlibcamera-stillより遅い。
| 構成 | 1枚目 | 2枚目以降 |
|---|---|---|
| Picamera2 AWBオフ + buffer_count=1(デフォルト) | 2.65秒 | 5.3秒 |
| Picamera2 AWBオフ + buffer_count=2 | 2.65秒 | 1.88秒 |
| libcamera-still AWBオフ | 4.3秒 | 4.3秒(毎回) |
数値を見た瞬間に「バッファが詰まっている」と想像はついた。ただ、デフォルト値がそういう設定になっているとは思っていなかった。
create_still_configuration() のデフォルトは buffer_count=1。バッファが1つしかないと、ファイル保存が完了してバッファを解放するまでカメラが次の露光を開始できない。
buffer_count=1:
[露光2s ─────────][保存0.65s] → [露光2s ─────────][保存0.65s] → ...
                  ↑ここで詰まる(2枚目は保存完了を待ってから開始)

buffer_count=2:
[露光2s ─────────][保存0.65s]
                  [露光2s ─────────][保存0.65s]
buffer_count=2 を指定するだけで解決する。カメラは1枚目のバッファを保存処理に渡しながら、2枚目のバッファで次の露光を並行して開始できる。実測値1.88秒はほぼ露光時間と一致していて、理論通りの結果だ。
30秒露光で同じ問題が起きていたら「露光30s + 保存0.65s + 待ち30s」で1枚あたり実質60秒になる。Picamera2の公式ドキュメントにも buffer_count の記述はあるが、デフォルト値の挙動について特に警告はない。連続撮影のパフォーマンスを計測して初めて気づく類の設定だ。
正しい長時間露光コード
from picamera2 import Picamera2

cam = Picamera2()
config = cam.create_still_configuration(
    main={"size": (4056, 3040)},
    buffer_count=2,              # デフォルト1だと連続撮影が2倍遅くなる
)
cam.configure(config)

cam.set_controls({
    "AeEnable": False,
    "AwbEnable": False,                           # オンだと3.8倍遅くなる
    "ExposureTime": 30_000_000,                   # 30秒(マイクロ秒単位)
    "AnalogueGain": 4.0,
    "ColourGains": (1.5, 1.5),                    # AWBオフ時は固定値を指定
    "FrameDurationLimits": (30_000_000, 30_000_000),
})

cam.start()

for i in range(3):
    cam.capture_file(f"shot_{i:03d}.jpg")
buffer_count=2 と AwbEnable=False の2行が今回の肝だ。
おわりに
| 項目 | 旧(libcamera-still) | 新(Picamera2) |
|---|---|---|
| 連写1枚あたり(露光10ms) | 2.08秒 | 0.68秒(3.1倍速) |
| シャッターラグ(平均) | — | 0.46秒 |
| 長時間露光 連続2枚目以降 | 4.3秒/枚 | 1.88秒/枚 |
Picamera2への移行自体は難しくない。ただし「デフォルトのまま動かしているのに何か遅い」は計測しないと見えてこない。AWBとbuffer_countはどちらも「とりあえず動く」設定のままでも問題が出ないケースが多く、長時間露光の連続撮影という特定の条件下でだけ顕在化する。
自分で計測して初めて「なぜこの数値なのか」を考えることになった。長時間露光を扱うなら、この2つは必ず確認する設定だ。
この検証結果をもとに、Raspberry Pi + HQカメラモジュールで自作デジカメを作ることにした。それについてはまた別の記事で。
AI個人開発の仕組みづくり
新規プロジェクトに適用する開発基盤の設計記録。
1. はじめに
動機
従来の個人開発は main ブランチに直 commit するだけで済んだ。AI と協働する開発、特に複数の AI エージェントが並行して動く前提に立つと、従来チーム開発でしか必要とされなかった要素 — ブランチ戦略、PR、CI/CD、レビュー体制 — が個人開発にも必要になる。
AI を「もう一人の開発者」として扱うなら、複数 AI との個人開発は実質的に「プロジェクト」である。本ドキュメントはそのプロジェクトを回すための土俵を定義する。
想定範囲
- 新規プロジェクトの開発基盤
- Git 運用、コミット規約、CI/CD、フック、ドキュメント構造
関連記事
本ドキュメントは以下の記事と一体で成立する。
- 課題編: 現状の Git 運用で感じている違和感と、これから来る変化(task-exec)
- メンタルモデル編: AI を「メンバー」として扱う視点
- 提言編・Author 設計: コミット Author の 3 パターン分離
2. 前提となるメンタルモデル
詳細は既存記事に譲り、ここでは要点のみ。
- AI を一人の開発者として扱う。「ツールを使う」ではなく「メンバーと働く」。
- コードの生まれ方は 3 パターン: 手動・対話式・自律式。それぞれレビュー観点が異なる。
- チーム運営の知見を借りる。引き継ぎ・Wiki・プロセス自動化は AI 運用にそのまま転用できる。
- お願いベースで動かないものは仕組みに落とす。
3. 判定原則: お願いと仕組みの境界
ルールを「お願い(CLAUDE.md に書くだけ)」にするか「仕組み(hook / CI / スクリプトで強制)」にするかを判断するための原則。
主軸 (2 × 2)
- 被害: そのルールが破られたときの影響の大きさ。大 / 小
- コスト: 仕組み化に必要な実装作業の量。軽 / 重
| コスト: 軽 | コスト: 重 | |
|---|---|---|
| 被害: 大 | 仕組み化 | 仕組み化 |
| 被害: 小 | 仕組み化 | お願い → 追加チェック |
追加チェック (お願いゾーンに入った場合のみ)
以下の 3 つすべてが yes なら、お願いのままで安心。1 つでも no があれば仕組み化を再検討する。
- [ ] そのルールは直近で破られていないか?
- [ ] タスクの自然な流れに乗っているか? (脇道の追加操作ではないか)
- [ ] 発動タイミングが明示的か? (コミット時・PR 時など決まった瞬間)
4. Git 戦略
仕組みで強制される
- メインブランチ:
master - 作業ブランチ:
dev_* - すべての変更は PR 経由
masterへの直 push 禁止(Gitea ブランチ保護)- マージ方式: merge commit(Gitea 設定)
- ホスティング: Gitea(新規案件のみ)
お願い
- ベース戦略は GitHub flow
- 作業ブランチは短命(1日以内)、起点が人間であることで担保
- 自律式エージェント(task-exec 等)は PR 作成までを担当し、マージの指示は人間
- PR が日を跨いだ場合は、レビュー時に「最新の master を取り込んで」と指示
5. Author 規約
詳細は既存記事(提言編・Author 設計)を参照。要点のみ。
規約
- 手動: 開発者名(例:
DAIMOX <...>) - 対話式: モデル名(バージョン込み、例:
Claude Sonnet 4.6 <noreply@anthropic.com>) - 自律式: エージェント名(例:
task-exec [bot] <bot@local>)
実装は環境変数による分岐で対応(例: TASK_EXEC_TASK_ID が設定されていれば自律式 Author)。
6. コミット・バージョン
仕組みで強制される
- バージョンファイルの更新はバンプスクリプト経由のみ(手動編集禁止)
- バンプスクリプトの呼び出し方は土俵レベルで統一(具体的なコマンド名は別途決定)
- PR 時にバージョンファイル更新チェック(ソース変更がある場合)
- PR 本文に
[skip-version]を含めればチェックをスキップ可
お願い
- コミットメッセージ先頭にバージョン表記(例:
v0.2.4 チャットのバグ修正) - コミットメッセージは日本語
- レビュー修正のたびにパッチアップ(
v1.2.0 → v1.2.1 → v1.2.2) - マイナー以上の最終確定でタグを打つ(
git tag vX.Y.Z+git push origin --tags)
バンプスクリプトの設計
- 各プロジェクトにバージョンバンプスクリプトを必ず用意
- バージョンファイルの場所・形式はプロジェクトごとに自由(言語の慣習に従う)
- 中身: グローバル変数としてバージョン文字列を保持(例:
version.pyのVERSION = "1.2.3") - 関連箇所(HTML、package.json など)の同期はスクリプトが面倒を見る
バージョンアップ判定
CI でソース変更の有無を見てバージョンアップ要否を判定。
- ソース変更あり → バージョンアップ必須
- ドキュメント・コメントのみ → バージョンアップ不要
[skip-version]で例外指定可
7. CI/CD
ツール
Gitea Actions
仕組みで強制される
- PR 時に全件テスト(パターン A: バージョンアップ判定とは独立)
- PR 時にバージョンファイル更新チェック
- PR 時に試験成績書の存在チェック(マイナー以上のバージョンアップ時)
テストは全件実施する方針。
8. 試験成績書
仕組みで強制される
- 配置:
reports/test-results_vX.Y.Z.md - マイナー以上のバージョンアップで必須
- CI でバージョン差分から自動判定して存在チェック
試験成績書の必須要素は以下。 - バージョン番号 - 試験一覧 - 試験の概要 - 試験結果
9. フック (Claude Code hooks)
フック構成
- SessionStart:
git pull origin master(古い状態問題への対策) - PreToolUse (Bash):
- テストファイル存在チェック(
pre-commit-test.sh) - デプロイ前バージョン確認(
deploy.sh検出時、現在のバージョンを警告として注入)
- テストファイル存在チェック(
配布方法は.claude/ 配下をリポジトリに Git 管理。clone すれば自動で揃う。
10. CLAUDE.md の構造
三層構造
CLAUDE.md とその関連ドキュメントは三層構造で運用する。
- Layer 1: Principles — 全プロジェクト共通の原則(新規プロジェクト作成時にコピーされる)
- Layer 2: Configuration — プロジェクト固有の設定(技術スタック、Git remote、バンプスクリプトのパスなど)
- Layer 3: Knowledge — プロジェクトの設計判断・運用知識(設計メモ、インフラ構成、機能仕様、チェックリスト)
ファイル構成
CLAUDE.md             # Principles + Configuration + Knowledge への索引
docs/
├── architecture.md   # Knowledge: 設計メモ
├── infrastructure.md # Knowledge: 環境・本番構成
├── version-history.md # Knowledge: バージョン履歴
└── checklists/       # Knowledge: チェックリスト類
(Knowledge レイヤーの具体的なファイル名・構成はプロジェクトの内容次第で調整)
「仕組み済 / お願い」の表記方法
案 A(セクション分け)を採用。各カテゴリ内に以下のサブセクションを設ける。
## カテゴリ名

### 仕組みで強制される
- ルール A(強制方法の記載)
- ルール B(強制方法の記載)

### お願い
- ルール C
- ルール D
Principles の中身
判定原則(章 3)に基づいて、本ドキュメントの章 4〜9 で確定したルールを Principles に集約する。
| ルール | 強制/お願い |
|---|---|
| GitHub flow ベース | お願い |
| メインブランチは master | 仕組み |
作業ブランチは dev_* |
お願い |
| すべての変更は PR 経由 | 仕組み |
| マージ方式: merge commit | 仕組み |
| 自律式は PR 作成まで、マージの指示は人間 | お願い + Author 判定 |
| 作業ブランチは日を跨がない | お願い |
| Author 規約(3 パターン) | 仕組み |
| コミットメッセージ先頭にバージョン | お願い + CI 検証 |
| レビュー修正のたびにパッチアップ | お願い |
| マイナー以上でタグ打ち | お願い |
| バンプスクリプトを使う | 仕組み(CI + pre-commit) |
PR 本文 [skip-version] でスキップ |
仕組み |
| PR 時に全件テスト | 仕組み |
| 試験成績書(マイナー以上) | 仕組み |
| SessionStart で git pull master | 仕組み |
| pre-commit でテスト確認 | 仕組み |
| CLAUDE.md は三層構造 | 規約 |
Configuration のテンプレート
プロジェクトごとに以下のような項目を埋める形:
- バンプスクリプトの呼び出し方(例:
./tool/bump-version.sh X.Y.Z) - Git remote
- 技術スタック
- デプロイ手順
- プロジェクト固有のディレクトリ規約
- 使用モデル指定
Git Strategy in the AI Era — Who Authored This Commit?
Introduction
I’ve been developing Enklave, a private groupware app, with an autonomous deploy mechanism called task-exec. After running task-exec for a while, I noticed something off while scrolling through the commit log.
The log shows rows of Author: Claude. Some were written by task-exec autonomously. Others were written during interactive Claude Code sessions. But on the log, they were indistinguishable.
“Who wrote this?” “How did this code come to be?” Information I had always taken for granted in Git workflows had quietly become ambiguous the moment AI collaboration became part of my daily routine.
This post starts from that discomfort. I want to lay out how commit authorship should be redesigned for the AI era.
1. The problem
The Author of commits written by task-exec is currently the model name (Claude). This is the same as commits written through interactive Claude Code.
So my repository now contains two kinds of commits mixed together:
- Commits I wrote with Claude in an interactive session
- Commits task-exec wrote autonomously from a request
Both have Author: Claude. Running git log --author=Claude pulls them out together. Two kinds of commits with very different review requirements are treated as identical on Git.
How should we record commit authorship in the age of AI collaboration? This isn’t a local operational issue — it deserves to be sorted out as a strategic question about Git in the AI era.
2. Code enters a repo through three paths
When I tried to organize this, the paths code takes into a repo split into three:
| Path | Description |
|---|---|
| Manual | The developer writes code by hand |
| Interactive | The developer and AI write together (interactive Claude Code sessions, etc.) |
| Autonomous | The AI writes code autonomously from a request (agents like task-exec) |
The way the developer is involved is fundamentally different across these three.
Manual: the developer judges and writes each line. Interactive: the AI writes, but the developer reviews and accepts in real time. Autonomous: the developer only submitted a request and was not present when the code was written.
Review requirements differ too. Manual code is the developer’s intent itself. Interactive code has been confirmed in real time, so pre-merge review can be light. Autonomous code wasn’t reviewed in the moment, so a human must look at it before merge.
If the three paths can’t be distinguished, you can’t adjust the depth of review.
3. Separating layers of responsibility
Before mapping the three paths to an implementation, I want to sort out where responsibility sits.
Product-level responsibility lies with the developer. As the repository owner, deciding what eventually enters the codebase is a human’s job. That doesn’t change in the age of AI collaboration.
On the other hand, responsibility for individual commits lies with whoever actually wrote that code. If a human wrote it, the human. If an AI wrote it, the AI. If an autonomous agent wrote it, the agent.
I separate these two:
- Product responsibility → the developer (responsibility for running the repo)
- Commit responsibility → the Author (responsibility for that piece of code)
The developer carries product responsibility across all commits but doesn’t carry the “wrote it” responsibility for commits they didn’t write. The principle is to align the record with the fact.
4. The proposal for Author notation
Given the layered separation, the Author notation comes out as follows:
# Manual
Author: DAIMOX <...>

# Interactive
Author: Claude (Sonnet 4.5) <noreply@anthropic.com>

# Autonomous
Author: task-exec [bot] <bot@local>
For interactive commits, the Author is Claude alone. Claude wrote the code. I was the one who “made it write,” but not the one who wrote it.
For autonomous commits, the Author is task-exec itself. The fact that task-exec uses Claude internally is an implementation detail. The entity generating the commit is task-exec as a system. Claude is just a part operating inside it.
I include the model name (Claude (Sonnet 4.5) rather than just Claude) because the behavior of “Claude” varies by version. A moment will inevitably come when I want to distinguish commits made by Sonnet 4.5 from earlier ones.
5. Operational benefits
When the three paths use distinct Authors, identification with git log --author becomes immediately clear:
git log --author="DAIMOX"     # manual work only
git log --author="Claude"     # interactive work only
git log --author="task-exec"  # autonomous work only
The three paths separate mechanically. Switching review priority, running extra CI checks only on autonomous commits, aggregating past work logs — all of these reduce to a simple Author filter.
This isn’t reachable under the current “everything is Author: Claude” state.
6. A remaining limitation
There’s still a limitation in this proposal.
For interactive commits, I can write Claude (Sonnet 4.5) in the Author field, but I can’t trace which conversation produced it. Claude Code manages sessions at ~/.claude/projects/<project-id>/<session-id>.jsonl with assigned UUIDs. However, no official command exists to display the session ID during an interactive session. There’s an open feature request on GitHub, but it hasn’t been resolved.
Autonomous mode is controlled externally, so it’s technically possible to obtain the session ID and write it into the commit message as a trailer. But that opens the next problem.
7. A manager becomes necessary
Even if you can stamp the session ID into a commit, it’s useless without a way to get back to the conversation from the ID:
Commit → Session ID → ???
What’s needed here is a “manager that lets you list sessions and view their contents.” Concretely, a viewer with these capabilities:
- Walks
~/.claude/projects/locally and enumerates all sessions - Shows the first message of each session, or a summary
- Lays out metadata like model name, start time, project
- Links to Git history so you can jump from a commit’s session ID to the conversation
- Tags sessions with metadata for path (interactive / autonomous)
Tools of this kind are already emerging. Two examples:
- Mantra — a general-purpose session viewer supporting Claude Code, Cursor, and Gemini CLI. Reads JSONL, enables full-text search, and aligns Git history with timelines via a “Time Travel” feature. Closed-source, but local features are free
- Claude Code Trace — an open-source viewer that reads JSONL from
~/.claude/projects/and visualizes sessions. Works as desktop, web, and TUI
Both are optimized for “looking back on interactive sessions” and don’t quite reach the angle this post proposes — linking autonomous commits to session IDs for management.
The need for “linking session IDs, conversations, and Git” is starting to be recognized across the industry. I hope managers of this kind develop in step with the recording style I’m proposing here.
8. Conclusion
To summarize the proposal:
- Code arrives via three paths: manual, interactive, autonomous
- Separate product responsibility (developer) from commit responsibility (Author)
- The Author is a single entity that wrote it: the developer for manual, the model for interactive, the agent for autonomous
git log --authorcleanly separates the three paths- Session info should be recorded once interactive session ID retrieval is standardized
- A manager UI remains a future task
It isn’t a perfect solution. How session information will be handled depends a lot on future developments. But distinguishing the three paths and standardizing Author notation is something we can adopt right now.
I plan to rewrite my own task-exec to follow this proposal in the near future.
AI時代のGit戦略 提言編 — コミットの著者は誰か
はじめに
Enklaveの開発を進めている中で、task-execという自律デプロイ機構を運用するようになってから、コミットログを眺めていてふと違和感を覚えた。
ある日のコミット履歴を見ると、Author: Claude というコミットが並んでいる。task-execが自動で書いたものもあれば、自分が対話しながら書かせたものもある。だが、それらがログ上で区別できない。
「これは誰が書いたのか」「どういう経緯で生まれたコードなのか」。今までのGit運用では当たり前に追えていたはずの情報が、AI協働が日常になった瞬間に曖昧になっていた。
本記事はその違和感を起点にした提言である。コミットの著者表記をどう設計し直すべきか、自分なりの結論をまとめる。
1. 問題提起
現状のtask-execが書いたコミットのAuthorは、モデル名(Claude)になっている。これは対話式のClaude Codeで書いたコミットと同じ表記だ。
つまり、いま自分のリポジトリには次の2種類が混在している。
- 自分が対話しながらClaudeに書かせたコミット
- task-execが要望から自動で書いたコミット
どちらもAuthorは「Claude」。git log --author=Claude で抽出しても、両者が一緒に出てくる。レビュー観点が異なる2種類のコミットが、Git上では完全に同じものとして扱われている。
AIと協働する時代に、コミットの著者をどう記録すべきか。これは個別の運用問題ではなく、AI時代のGit戦略として整理されるべき論点だと考える。
2. コードの生まれ方は3パターンある
整理を始めると、コードがリポジトリに入る経路は3つに分かれる。
| パターン | 説明 |
|---|---|
| 手動 | 開発者が自分の手でコードを書く |
| 対話式 | 開発者とAIが対話しながら書く(Claude Codeでのインタラクティブ作業など) |
| 自律式 | AIが要望から自律的に書く(task-execのようなエージェント) |
この3つは、開発者の関与のされ方が根本的に違う。
手動は開発者が一行ずつ判断して書いている。対話式はAIが書くが、開発者がその場で内容を見て採用している。自律式は開発者が要望を出しただけで、コードを書く瞬間には立ち会っていない。
レビューの観点も違う。手動はそもそも開発者の意図そのものだ。対話式は開発者がリアルタイムで確認済みだから、マージ前のレビューは軽くて済む。自律式は開発者が即時判断していないため、マージ前に必ず人間が見る必要がある。
3パターンが区別できないと、レビューの厚みを使い分けられない。
3. 責任の階層を分離する
3パターンの区別を実装に落とす前に、責任の所在を整理しておく。
プロダクト全体の責任は開発者にある。リポジトリのオーナーとして、最終的にコードベースに何を入れるかを判断するのは人間だ。これはAI協働の時代になっても変わらない。
一方で、個々のコミットを書いた責任は、そのコードを実際に書いた主体にある。書いたのが人間なら人間、AIならAI、自律エージェントならエージェントだ。
この2つを分離する。
- プロダクト責任 → 開発者(リポジトリ運営の責任)
- コミット責任 → Author(そのコード片を書いた責任)
開発者は全てのコミットを通じてプロダクト責任を負うが、書いていないコミットの「書いた責任」までは負わない。書いた事実と一致させる、というのが原則になる。
4. Author表記の提言
責任の階層分離を前提にすると、Author表記は次のようになる。
# 手動
Author: DAIMOX <...>

# 対話式
Author: Claude (Sonnet 4.5) <noreply@anthropic.com>

# 自律式
Author: task-exec [bot] <bot@local>
対話式のAuthorはClaude単体にする。書いたのはClaudeであって、自分は「書かせた人」ではあっても「書いた人」ではない。
自律式のAuthorはtask-exec自身にする。task-execがClaudeを内部で使っているのは実装の話で、コミットを生む主体としてはtask-execというシステムが立っている。Claudeはその中で動いている部品にすぎない。
モデル名まで含めるのは、将来同じ「Claude」でもバージョン差で挙動が変わるためだ。Sonnet 4.5で書かれたコミットと、それより前のモデルで書かれたコミットを後から区別したい場面は必ず出てくる。
5. 運用上の利点
3パターンのAuthorを使い分けると、git log --author での識別が一気に明確になる。
git log --author="DAIMOX"     # 手動の作業だけ
git log --author="Claude"     # 対話式の作業だけ
git log --author="task-exec"  # 自律式の作業だけ
3パターンが機械的に分離できる。レビューの優先度を切り替えたいとき、CIで自律式コミットだけ追加検証を走らせたいとき、過去の作業ログを集計したいとき、いずれも単純なAuthorフィルタで済む。
これは現状の「全部Author: Claude」では到達できない領域だ。
6. 残る制限
ただし、この提言には残る制限がある。
対話式のAuthorに「Claude (Sonnet 4.5)」までは書けるが、どの会話で書かれたかは追えない。Claude Codeはセッションを ~/.claude/projects/<project-id>/<session-id>.jsonl で管理しており、UUIDが振られている。しかし対話セッション中にIDを表示する公式コマンドは現時点で存在しない。GitHubのIssueでフィーチャーリクエストが上がっている段階だ。
自律式は外部から制御するため、セッションIDを取得してコミットメッセージのtrailerに刻むことは技術的に可能だ。しかし、そこから先の問題が残る。
7. マネージャーが必要になる
セッションIDをコミットに刻めるようになっても、IDから会話に戻る手段がなければ役に立たない。
コミット → セッションID → ???
ここに「セッション一覧と会話の内容を見られるマネージャー」が要る。具体的には次のような機能を持つビューワーだ。
- ローカルの
~/.claude/projects/を走査して全セッションを列挙する - 各セッションの先頭メッセージ、または要約を表示する
- モデル名・開始日時・プロジェクトなどのメタデータを並べる
- Git履歴と紐付け、コミットのセッションIDから会話に飛べるようにする
- 方式(対話式・自律式)の区別をメタデータとして付与する
実は同種のツールはすでに登場し始めている。例えば次の2つがある。
- Mantra — Claude Code・Cursor・Gemini CLIに対応した汎用セッションビューワー。JSONLを読み込んで全文検索でき、Git履歴とタイムラインを整列させる「Time Travel」機能を持つ。クローズドソースだがローカル機能は無料
- Claude Code Trace —
~/.claude/projects/のJSONLを読んでセッションを可視化するオープンソースのビューワー。デスクトップ・Web・TUIで動作する
ただし、いずれも「対話セッションを後から振り返る」用途に最適化されており、本記事の提言にあるような「自律式コミットとセッションIDを紐付けて管理する」観点までは踏み込んでいない。
つまり「セッションIDと会話、Gitとの紐付け」という需要は、すでに業界で認識されつつある。提言した記録方式と歩調を合わせる形で、こうしたマネージャーが整備されていくことが望まれる。
8. おわりに
提言をまとめると次のようになる。
- コードの生まれ方は手動・対話式・自律式の3パターンに分かれる
- プロダクト責任は開発者、コミット責任はAuthorと階層を分ける
- Authorは書いた主体一人にする。手動なら開発者、対話式ならモデル、自律式ならエージェント
git log --authorでの識別が3パターンで完全に分離できる- セッション情報の記録は、対話セッションのID取得が標準化されてから本格化させる
- マネージャー機能の整備が将来的な課題として残る
完璧な解ではない。セッション情報をどう扱うかは今後の発展に委ねる部分が大きい。だが、3パターンの区別とAuthor表記の標準化は、今すぐ取り入れられる粒度だと考えている。
自分のtask-execも、近いうちにこの提言に沿った形に書き換える予定だ。
